Skip to content

Statistikos portalas

Statistikos naujienos ir pranešimai

  • Faktai
  • IT
  • Patarimai
  • Pranešimai
  • Statistika
  • Technika
  • Vilnius
  • Kompiuterių remontas Vilniuje
  • Kalbos
  • Aktyvumas
  • Komercija
  • Laisvalaikis
  • Nekilnojamas turtas
  • Paslaugos
  • Sveikata
  • Transportas
  • KONTAKTAI

Kategorija: Faktai

Dantų gydymo paslaugų prieinamumo ir kokybės pokyčiai Lietuvoje 2020-2025 metais: statistinė analizė ir pacientų elgsenos tendencijos

Posted on 17 spalio, 202517 spalio, 2025 By www.statisticsjournal.lt
Dantų gydymo paslaugų prieinamumo ir kokybės pokyčiai Lietuvoje 2020-2025 metais: statistinė analizė ir pacientų elgsenos tendencijos
Faktai, Paslaugos

Kaip pasikeitė dantų gydymo peizažas per pastaruosius penkerius metus

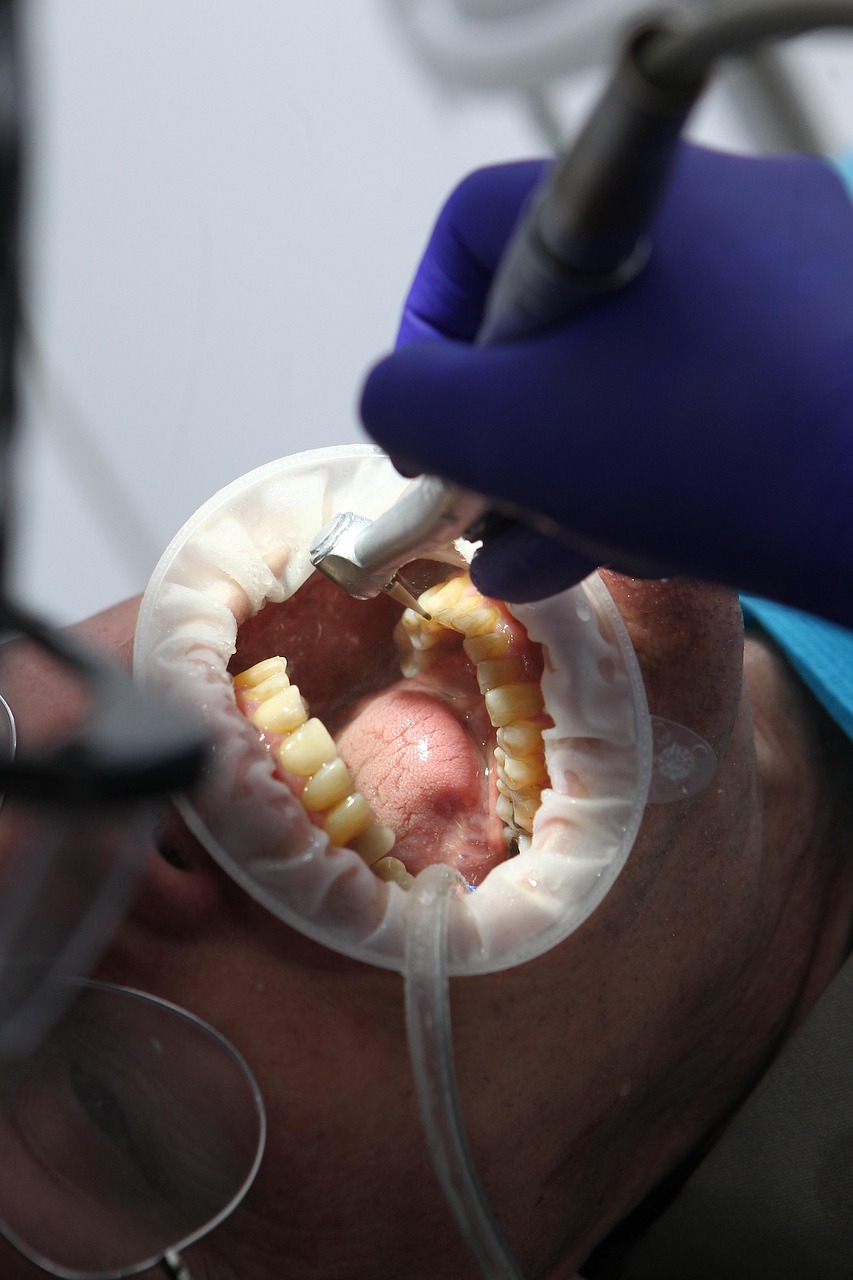
Kai 2020-aisiais prasidėjo pandemija, niekas negalėjo įsivaizduoti, kokią revoliuciją ji sukels dantų gydymo srityje Lietuvoje. Dabar, žvelgdami atgal į šį penkmetį, matome ne tik statistinius pokyčius, bet ir fundamentaliai pasikeitusį požiūrį į burnos sveikatą. Jei anksčiau pas odontologą dažnas eidavo tik tada, kai dantis jau nebeatlaikydavo, tai šiandien situacija kardinaliai kitokia.

Statistikos departamento duomenys rodo, kad nuo 2020 iki 2025 metų privačių odontologijos klinikų skaičius Lietuvoje išaugo net 23 procentais. Tai nėra atsitiktinumas – tai atspindi augančią paklausą ir besikeičiančius žmonių įpročius. Įdomiausia tai, kad didžiausias augimas fiksuojamas ne sostinėje, o regionuose. Klaipėdoje, Kaune, Panevėžyje ir net mažesniuose miestuose atsirado modernių, gerai įrengtų klinikų, kurios nebenusileidžia Vilniaus standartams.

Kompensavimo sistemos evoliucija – nuo popierinių kvitų iki skaitmeninių sprendimų

Privalomojo sveikatos draudimo fondo (PSDF) kompensavimo sistema patyrė tikrą metamorfozę. 2020 metais vidutinė kompensacija už dantų gydymą sudarė apie 42 eurus per metus vienam apdraustam asmeniui. 2025-aisiais ši suma išaugo iki 67 eurų – tai beveik 60 procentų padidėjimas! Bet dar svarbiau – supaprastėjo pati procedūra.

Anksčiau žmonės turėjo rinkti popierinius kvitus, pildyti prašymus, laukti mėnesių. Dabar dauguma klinikų integruotos į elektroninę sistemą, ir kompensacija ateina beveik automatiškai. Tai paskatino žmones aktyviau naudotis teise gauti kompensaciją – jei 2020-ais tik apie 34 procentai turinčiųjų teisę realiai pasinaudodavo šia galimybe, tai 2025-aisiais šis skaičius peršoko 58 procentų ribą.

Ypač džiugina, kad išsiplėtė ir kompensuojamų paslaugų spektras. Dabar lengviau gauti kompensaciją už periodontologinį gydymą, sudėtingesnes endodontines procedūras, net už kai kurias ortodontines paslaugas vaikams. Tai realiai padėjo šeimoms su mažesnėmis pajamomis geriau prižiūrėti dantis.

Pacientų elgsenos revoliucija – nuo reaktyvaus iki proaktyvaus požiūrio

Turbūt pats įdomiausias pokytis – tai kaip pasikeitė pačių žmonių požiūris. Sveikatos apsaugos ministerijos užsakyti tyrimai rodo fascinuojančią tendenciją: profilaktinių vizitų dalis išaugo nuo 31 procento 2020-aisiais iki 52 procentų 2025-aisiais. Tai reiškia, kad daugiau nei pusė žmonių dabar eina pas odontologą ne todėl, kad skauda, o todėl, kad nori išvengti problemų.

Ką tai lėmė? Pirma, informacijos prieinamumas. Socialiniai tinklai, https://azklinika.lt/ ir ypač Instagram ir TikTok, tapo netikėtais sveikatos švietimo įrankiais. Odontologai pradėjo aktyviai dalintis patarimais, rodė procedūras, aiškino prevencijos svarbą. Antra, pandemija išmokė mus vertinti sveikatą kitaip – žmonės suprato, kad geriau investuoti į prevenciją nei vėliau mokėti už brangų gydymą.

Trečia, ir labai svarbu – pasikeitė pačių klinikų komunikacija. Daugelis pradėjo siųsti priminimus apie patikrinimus, pasiūlyti lanksčius laikus, sukurti lojalumo programas. Viena Vilniaus klinika man pasakojo, kad įdiegus automatinių SMS priminimų sistemą, profilaktinių vizitų skaičius išaugo 40 procentų per metus!

Technologijų šuolis – kai odontologija susitinka su digitalizacija

Jei 2020-aisiais 3D skenavimas buvo egzotika, tai dabar tai standartas daugelyje klinikų. Skaitmeninė odontologija tapo ne prabanga, o norma. CAD/CAM technologijos leidžia pagaminti karūnėles per vieną vizitą, o ne laukti savaites su laikinosiomis. Tai ne tik patogu – tai keičia visą patirtį.

Intraoralni skeneriai pakeitė tuos bjaurius atspaudus, nuo kurių visi vemti norėdavome. Dabar odontologas tiesiog kelias minutes skenuoja dantis specialiu prietaisu, ir viskas! Kompiuterio ekrane iškart matai savo dantų 3D modelį. Viena mano pažįstama, kuri turi stiprų pykinimo refleksą, sako, kad tai ją išgelbėjo – anksčiau ji vengė bet kokių procedūrų, o dabar jaučiasi komfortiškai.

Dirbtinis intelektas irgi pradėjo skverbtis į odontologiją. Yra programų, kurios analizuoja rentgeno nuotraukas ir padeda gydytojui pastebėti ankstyvus ėduonies požymius, kuriuos žmogaus akis galėtų praleisti. Keli dideli tinklai Lietuvoje jau naudoja tokias sistemas kaip papildomą saugiklį.

Kainų dinamika – ar dantų gydymas tapo prieinamesnis?

Čia situacija dviprasmiška. Viena vertus, vidutinės paslaugų kainos išaugo apie 35-40 procentų per šiuos penkerius metus. Tai atspindi ir bendrą infliaciją, ir išaugusias medžiagų kainas, ir investicijas į naują įrangą. Paprasta plomba, kuri 2020-aisiais kainavo 40-50 eurų, dabar kainuoja 60-75 eurus.

Bet kita vertus – jei žiūrime į realią prieinamumą, situacija pagerėjo! Kaip tai įmanoma? Pirma, konkurencija išaugo, ir tai lėmė kainų stabilizavimą kai kuriose srityse. Antra, atsirado daugiau lanksčių mokėjimo būdų – išsimokėtinai, per finansavimo kompanijas, lojalumo programos. Trečia, ta pati kompensavimo sistema, kuri tapo efektyvesnė.

Ypač įdomu, kad atsirado segmentacija. Yra premium klinikų, kur kainos tikrai aukštos, bet siūloma išskirtinė patirtis. Yra vidutinio segmento klinikų su geru kokybės ir kainos santykiu. Ir yra biudžetinių variantų, kur gali gauti kokybišką, bet bazinį gydymą už prieinamą kainą. Kiekvienas gali rasti sau tinkamą variantą – 2020-aisiais tokios įvairovės tiesiog nebuvo.

Regioniniai skirtumai – ar Lietuva tampa vienodesnė?

Vienas džiugiausių pokyčių – mažėjantis atotrūkis tarp Vilniaus ir regionų. 2020 metais skirtumas tarp sostinės ir mažesnių miestų buvo akivaizdus – ir paslaugų kokybės, ir prieinamumo, ir kainų prasme. Dabar šis atotrūkis sparčiai mažėja.

Klaipėdoje ir Kaune atsirado klinikų, kurios nebenusileidžia geriausiosioms Vilniaus įstaigoms. Įdiegta pažangiausia įranga, dirba aukštos kvalifikacijos specialistai, daugelis jų mokėsi užsienyje ar reguliariai vyksta į tarptautinius mokymus. Vienas Kauno odontologas man pasakojo, kad jų klinika investavo per 200 tūkstančių eurų į naują įrangą per pastaruosius trejus metus – tai rimtas įsipareigojimas kokybei.

Net mažesniuose miestuose – Alytuje, Mažeikiuose, Utenoje – situacija gerėja. Tiesa, čia vis dar yra iššūkių su specialistų pritraukimu, bet ir tai keičiasi. Kai kurios klinikų grupės pradėjo plėstis į regionus, atsinešdamos savo standartus ir sistemas. Tai kelia kartelę visam sektoriui.

Laukimo laikas irgi sutrumpėjo. 2020-aisiais regionuose kartais tekdavo laukti net mėnesį planuojamam vizitui. Dabar daugumoje vietų gali patekti per savaitę-dvi, o skubiais atvejais – tą pačią ar kitą dieną. Tai didelis proveržis prieinamumo prasme.

Kokybės standartų kilimas – kai pacientas tampa reiklus

Pacientai tapo daug reiklesni, ir tai puiku! Socialiniai tinklai, atsiliepimai internete, rekomendacijų kultūra – visa tai privertė klinikas rimtai susirūpinti kokybe. Nebepakanka tiesiog „sutaisyti dantį” – žmonės nori visos patirties: nuo registracijos telefonu iki povizitinės priežiūros.

Higienos standartai pakilo į naują lygį. Jei anksčiau ne visi atkreipdavo dėmesį į sterilizacijos procedūras, tai po pandemijos tai tapo absoliučiu prioritetu. Daugelis klinikų įsirengė stiklines sienas, kad pacientai galėtų matyti sterilizacijos kambarius. Vienkartiniai įrankiai, modernios autoklavos, griežti protokolai – tai dabar standartas, ne išimtis.

Skausmo valdymas irgi žengė į priekį. Naujos anestezijos technikos, sedacija azoto oksidu lengvesnėms procedūroms, net bendroji anestezija sudėtingesniais atvejais – visa tai tapo prieinamesne. Žmonės, kurie anksčiau vengė odontologų dėl baimės, dabar gali jaustis saugiai.

Komunikacijos kokybė – dar viena sritis, kur matome pažangą. Gydytojai išmoko aiškinti, ką jie daro ir kodėl. Naudoja vizualizacijas, rodo nuotraukas, aptaria alternatyvas. Pacientas dalyvauja sprendimų priėmime, o ne tiesiog klausosi nuosprendžio. Tai kuria pasitikėjimą ir geresnius rezultatus.

Į ką žiūrėti ir ko tikėtis toliau – dantų gydymo ateitis jau čia

Žvelgiant į šiuos penkmetį, matome ne tiesiog statistinius pokyčius, o tikrą transformaciją. Dantų gydymas Lietuvoje tapo prieinamesnis, kokybiškas ir pacientui draugiškesnis. Žmonės suprato prevencijos svarbą ir pradėjo investuoti į savo burnos sveikatą. Technologijos padarė procedūras greitesnes, tikslesnes ir mažiau nemalonias.

Ar viskas tobula? Žinoma, ne. Vis dar yra žmonių, kuriems dantų gydymas per brangus. Vis dar trūksta specialistų kai kuriose srityse – ypač vaikų odontologų ir ortodontų. Kompensavimo sistema, nors ir pagerėjo, vis dar galėtų būti dosnesnė.

Bet bendras vektorius aiškus – judame teisinga kryptimi. Konkurencija skatina kokybę, technologijos daro paslaugas geresnes, o didėjantis sąmoningumas reiškia, kad žmonės rūpinasi savo dantimis geriau nei bet kada anksčiau. Jei šis tempas išliks, po penkerių metų Lietuvos odontologija gali tapti viena pažangiausių regione.

Mano patarimas kiekvienam – nelauk, kol skauda. Rask gerą odontologą, su kuriuo jaučiesi patogiai, ir lankykis reguliariai. Investicija į prevenciją visada atsipirks – ir finansiškai, ir sveikatos prasme. Pasinaudok kompensavimo sistema, nepalik pinigų ant stalo. Ir nebijok klausti, domėtis, reikalauti kokybės – tai tavo sveikata ir tavo pinigai. Odontologijos pasaulis pasikeitė, ir dabar tikrai yra už ką džiaugtis!
Kaip skaityti statistinius duomenis ir nepasiduoti klaidinančioms interpretacijoms: praktinis vadovas

Posted on 14 spalio, 2025 By www.statisticsjournal.lt
Kaip skaityti statistinius duomenis ir nepasiduoti klaidinančioms interpretacijoms: praktinis vadovas
Faktai, Patarimai

Kodėl statistika taip lengvai apgauna

Statistika – tai tarsi peilis: galima ja supjaustyti duoną, o galima ir susižeisti. Problema ne pačioje statistikoje, o tame, kaip mes ją skaitome. Dauguma žmonių mato skaičių ir galvoja: „Na, tai faktas.” Bet skaičius be konteksto yra beveik beprasmis, o kartais net pavojingas.

Paimkime paprastą pavyzdį. Jei kažkas jums sako, kad „nauja dieta padeda numesti 10 kilogramų”, klausimas nėra „ar tai tiesa?”, o „palyginus su kuo?” Gal žmonės be jokios dietos per tą patį laikotarpį numeta 8 kilogramus. Tada ta „stebuklinga” dieta duoda vos 2 kilogramų skirtumą. Ar tai vis dar įspūdinga?

Absoliutūs ir santykiniai skaičiai – klasikinė pinklė

Vienas dažniausių manipuliavimo būdų – žaisti absoliučiais ir santykiniais dydžiais. Tarkime, vaistas sumažina širdies priepuolio riziką 50%. Skamba fantastiškai, tiesa? Bet jei ta rizika buvo 2%, o tapo 1% – tai absoliutus sumažėjimas tėra 1 procentinis punktas. Ar verta gerti vaistą dėl tokio skirtumo? Tai jau kitas klausimas.

Žiniasklaida dažnai renkasi tą versiją, kuri skamba dramatiškiau. Ir tai suprantama – 50% sumažėjimas skamba daug geriau nei „vienas iš šimto žmonių papildomai išvengs priepuolio”. Todėl kai matote procentus, visada klauskite: o koks buvo pradinis skaičius?

Koreliacija nėra priežastingumas – bet tai ne tik frazė

Šią frazę visi girdėjo, bet retai kas ją tikrai taiko. Koreliacija reiškia, kad du dalykai kinta kartu. Priežastingumas reiškia, kad vienas sukelia kitą. Skirtumas milžiniškas.

Klasikinis pavyzdys: šalyse, kur žmonės valgo daugiau šokolado, daugiau Nobelio premijų laureatų. Ar šokoladas daro žmones protingesnius? Žinoma, ne. Tiesiog turtingesnės šalys gali sau leisti ir daugiau šokolado, ir geresnį mokslą. Trečias veiksnys – turtingumas – paaiškina abu.

Kai matote tyrimą, kuris sako „X susijęs su Y”, pagalvokite: ar gali būti koks nors Z, kuris lemia abu? Dažnai taip ir yra.

Imties dydis ir reprezentatyvumas

Tyrimas su 30 žmonių ir tyrimas su 30 000 žmonių – tai du visiškai skirtingi dalykai, net jei rezultatai panašūs. Mažos imties tyrimai yra labai jautrūs atsitiktinumui. Gali tiesiog „pasisekti” gauti tokius rezultatus, kurie kitą kartą nepasikartos.

Bet imties dydis – tik pusė istorijos. Svarbu ir tai, kas į tą imtį patenka. Jei apklausiate žmones universiteto koridoriuje apie politines pažiūras, jūsų imtis tikrai neatspindės visos visuomenės. Tai vadinama atrankos šališkumu, ir jis gali visiškai iškreipti rezultatus, net jei apklausėte tūkstančius žmonių.

Kaip apsisaugoti – ne taisyklės, o mąstymo įprotis

Nereikia tapti statistiku, kad nesusipainioti duomenyse. Pakanka kelių klausimų, kuriuos užduodate sau kiekvieną kartą, kai matote statistiką.

Pirma – kas tai matuoja ir kaip? Pavyzdžiui, „laimė” skirtinguose tyrimuose matuojama visiškai skirtingai. Vienas klausia „ar esate laimingas?”, kitas – „kiek kartų per savaitę jaučiate teigiamas emocijas?” Tai nėra tas pats dalykas.

Antra – kas finansavo tyrimą? Tai ne sąmokslo teorija, o sveika nuovoka. Tyrimai, finansuojami pramonės, kuri turi interesą gauti tam tikrus rezultatus, statistiškai dažniau tuos rezultatus ir gauna. Tai nereiškia, kad tokie tyrimai meluoja – bet verta žinoti.

Trečia – ar yra alternatyvus paaiškinimas? Prieš priimdami vieną interpretaciją, pagalvokite, ar galima paaiškinti tą patį kitaip. Jei galima – reikia daugiau įrodymų.

Statistika kaip pokalbis, o ne nuosprendis

Geriausias būdas žiūrėti į statistinius duomenis – ne kaip į galutinį atsakymą, o kaip į pradžią pokalbio. Kiekvienas tyrimas yra vienas žingsnis, ne visa tiesa. Mokslininkai tai žino ir todėl nuolat kartoja tyrimus, tikrina vienas kito darbus, keičia išvadas.

Problema kyla tada, kai žiniasklaida ar socialiniai tinklai paima vieną tyrimą ir pateikia jį kaip „mokslas įrodė”. Mokslas retai ką nors „įrodo” vienu tyrimu – jis kaupia įrodymus lėtai, nuosekliai, dažnai su klaidomis pakeliui.

Taigi kai kitą kartą matysite antraštę su procentais, stebuklais ar „mokslininkų atradimais” – sustokite sekundei. Paklauskite paprastų klausimų. Ne tam, kad viskuo abejotumėte, o tam, kad suprastumėte tiek, kiek iš tikrųjų galima suprasti. Tai ir yra statistinis raštingumas – ne skaičių žinojimas, o gebėjimas su jais gyventi neprarandant kritinio mąstymo.

Ford dalių rinkos analizė: kaip statistikos duomenys atskleidžia vartotojų poreikių tendencijas ir padeda optimizuoti atsargų valdymą

Posted on 5 spalio, 2025 By www.statisticsjournal.lt
Ford dalių rinkos analizė: kaip statistikos duomenys atskleidžia vartotojų poreikių tendencijas ir padeda optimizuoti atsargų valdymą
Faktai, Komercija

Automobilių dalių rinka išgyvena nuolatinę transformaciją, o Ford, kaip vienas didžiausių automobilių gamintojų pasaulyje, susiduria su kompleksiniais iššūkiais valdant atsargas ir tenkinant vartotojų poreikius. Statistikos duomenų analizė tampa ne tik pagalbiniu įrankiu, bet ir strateginiu sprendimų priėmimo pagrindu, leidžiančiu prognozuoti rinkos pokyčius ir optimizuoti verslo procesus.

Šiuolaikinė Ford dalių rinka apima ne tik tradicinius komponentus, bet ir vis daugiau elektroninių sistemų, hibridinių technologijų elementų bei specializuotų detalių. Tokia įvairovė reikalauja sofistikuoto požiūrio į duomenų analizę, nes skirtingų dalių grupių poreikiai kinta nevienodai ir priklauso nuo daugybės veiksnių.

Rinkos segmentacijos ypatumai ir jų poveikis paklausai

Ford dalių rinka pasižymi aiškia segmentacija, kuri formuojasi pagal automobilių amžių, modelių populiarumą ir geografinę sklaidą. Statistikos duomenys atskleidžia, kad naujesnių modelių dalių paklausa koncentruojasi pirmaisiais eksploatacijos metais, kai vyrauja garantiniai remontai ir smulkūs gedimų šalinimo darbai. Tuo tarpu 5-15 metų amžiaus automobilių segmente dominuoja dilimo dalių paklausa.

Ypač reikšminga tendencija – elektrinių ir hibridinių Ford modelių dalių poreikių augimas. Nors šis segmentas dar sudaro santykinai nedidelę rinkos dalį, jo metinis augimas siekia 25-30 procentų, o tai reikalauja iš anksto planuoti atsargų struktūros pokyčius. Baterijų valdymo sistemų komponentai, elektros variklių dalys ir specializuoti jutikliai formuoja naują poreikių kategoriją.

Geografinis aspektas taip pat daro poveikį paklausos formavimui. Šiaurės Amerikos rinkoje dominuoja pikap ir SUV modelių dalys, Europoje – kompaktiškų automobilių komponentai, o Azijos rinkose vis labiau populiarėja hibridinių sistemų elementai. Tokia diferenciacija reikalauja regioninio atsargų valdymo modelio.

Sezoninių svyravimų identifikavimas ir prognozavimas

Statistikos duomenų analizė atskleidžia aiškius sezoninės paklausos modelius Ford dalių rinkoje. Žiemos laikotarpiu dramatiškai išauga akumuliatorių, šildymo sistemų komponentų ir padangų poreikis. Duomenys rodo, kad lapkričio-sausio mėnesiais šių kategorijų pardavimai padidėja 40-60 procentų, palyginti su vasaros laikotarpiu.

Pavasario sezonas pasižymi stabdžių sistemų dalių, pakabos komponentų ir valytuvo sistemų elementų paklausos augimu. Tai susiję su intensyvesniu automobilių naudojimu po žiemos periodo ir poreikiu atlikti techninės priežiūros darbus. Statistikos analizė leidžia nustatyti, kad kovo-gegužės mėnesiais šių dalių pardavimai viršija metinį vidurkį 25-35 procentais.

Vasaros laikotarpis formuoja specifinę paklausos struktūrą – išauga kondicionavimo sistemų dalių, aušinimo sistemų komponentų ir kelionių metu intensyviau naudojamų sistemų elementų poreikis. Liepos-rugsėjo mėnesiais šių kategorijų pardavimai padidėja 30-45 procentų.

Technologinių pokyčių poveikis dalių paklausai

Automobilių technologijų evoliucija formuoja kardinalius pokyčius Ford dalių paklausos struktūroje. Tradicinių mechaninių komponentų poreikis palaipsniui mažėja, tuo tarpu elektroninių sistemų elementų paklausa auga eksponentiniu tempu. Per pastaruosius trejus metus elektroninių valdymo blokų pardavimai išaugo 85 procentų.

Ypač reikšmingas pokytis – saugos sistemų komponentų paklausos augimas. Jutiklių, kamerų, radarų ir kitų ADAS (Advanced Driver Assistance Systems) sistemų elementų poreikis kasmet didėja 40-50 procentų. Tai reikalauja ne tik atsargų struktūros peržiūros, bet ir specialistų kvalifikacijos kėlimo.

Infotainment sistemų komponentai formuoja atskirą augančią kategoriją. Ekranų, navigacijos sistemų dalių, garso įrangos elementų paklausa kasmet auga 20-25 procentais. Šių dalių specifiškumas – trumpas technologinis ciklas ir poreikis dažnai atnaujinti atsargas.

Atsargų optimizavimo strategijos remiantis duomenų analize

Efektyvus atsargų valdymas Ford dalių sektoriuje reikalauja daugialygės analizės sistemos, kuri integruoja istorinių duomenų analizę, realaus laiko paklausos stebėjimą ir prognozavimo algoritmus. ABC analizės metodas leidžia kategorizuoti dalis pagal jų svarbą ir apyvartos intensyvumą.

A kategorijos dalys – didelio apyvarumo komponentai, sudarantys 70-80 procentų pardavimų apimties. Šioms dalims taikomas JIT (Just-in-Time) principas su trumpais papildymo ciklais ir aukštu aptarnavimo lygiu. Statistikos duomenys rodo, kad optimalus šių dalių atsargų lygis sudaro 15-20 dienų poreikį.

B kategorijos dalys reikalauja balansuoto požiūrio tarp atsargų išlaikymo kaštų ir aptarnavimo lygio. Šioms dalims rekomenduojamas 30-45 dienų atsargų lygis su reguliariu poreikių prognozavimu. C kategorijos dalys – mažo apyvarumo komponentai, kuriems taikomas ekonominio užsakymo kiekio modelis.

Dinaminis atsargų valdymas reikalauja nuolatinio duomenų atnaujinimo ir algoritmų tobulinimo. Mašininio mokymosi metodai leidžia identifikuoti nestandartinius paklausos modelius ir automatiškai koreguoti atsargų lygius. Tokia sistema gali sumažinti atsargų išlaikymo kaštus 15-25 procentų, išlaikant aukštą aptarnavimo lygį.

Vartotojų elgsenos analizė ir jos praktinis taikymas

Šiuolaikinė vartotojų elgsenos analizė Ford dalių rinkoje apima ne tik pirkimo modelių studijavimą, bet ir klientų lojalumo, preferencijų bei sprendimų priėmimo procesų tyrimą. Duomenys atskleidžia, kad 65 procentai vartotojų prioritetą teikia originalių dalių pirkimui, tačiau kainų jautrumas išlieka aukštas.

Internetinių pirkimų tendencijos formuoja naują vartotojų elgsenos modelį. Per pandemiją internetinių Ford dalių pardavimų dalis išaugo nuo 25 iki 45 procentų ir išlieka stabili. Tai reikalauja omnikanalio atsargų valdymo strategijos, kuri integruoja fizinių ir virtualių pardavimo kanalų poreikius.

Klientų segmentacijos analizė atskleidžia tris pagrindines grupes: profesionalūs mechanikai (40 proc. rinkos), automobilių savininkai, atliekantys remontą savarankiškai (35 proc.), ir automobilių servisai (25 proc.). Kiekviena grupė pasižymi skirtingais pirkimo ciklais, kiekių poreikiais ir aptarnavimo reikalavimais.

Prognozavimo modelių taikymas ir jų tikslumas

Ford dalių paklausos prognozavimas reikalauja kompleksinio modelių derinio, kuris apima tiek tradicinius statistikos metodus, tiek pažangius mašininio mokymosi algoritmus. Laiko eilučių analizės metodai efektyviai identifikuoja sezonines tendencijas ir ciklinius svyravimus, pasiekdami 85-90 procentų tikslumo lygį trumpalaikėms prognozėms.

Regresinės analizės modeliai leidžia įvertinti išorinių veiksnių poveikį paklausai. Ekonominiai rodikliai, degalų kainos, automobilių registracijos statistikos duomenys ir net oro sąlygų prognozės gali pagerinti prognozių tikslumą 10-15 procentų. Ypač efektyvūs tokie modeliai prognozuojant sezonines dalis.

Neurontinių tinklų algoritmai demonstruoja aukščiausią tikslumą analizuojant kompleksinius paklausos modelius. Šie metodai gali identifikuoti nelinearines priklausomybes tarp skirtingų veiksnių ir pasiekti 92-95 procentų tikslumo lygį vidutinės trukmės prognozėms. Tačiau jų taikymas reikalauja didelių duomenų masyvų ir specializuotų kompetencijų.

Duomenimis grįsto sprendimų priėmimo kultūros formavimas

Sėkmingo atsargų valdymo pagrindas – organizacijos kultūros transformacija link duomenimis grįsto sprendimų priėmimo. Ford dalių sektorius reikalauja ne tik technologinių sprendimų diegimo, bet ir darbuotojų kompetencijų plėtojimo duomenų analizės srityje. Praktika rodo, kad organizacijos, investavusios į analitinių įgūdžių ugdymą, pasiekia 20-30 procentų geresnių rezultatų atsargų valdymo efektyvume.

Duomenų kokybės užtikrinimas formuoja visų procesų pagrindą. Neišsamūs ar netikslūs duomenys gali suklaidinti net pažangiausius algoritmus ir privesti prie klaidingų sprendimų. Rekomenduojama įdiegti automatizuotas duomenų validavimo sistemas ir reguliariai atlikti duomenų auditus.

Realaus laiko analitikos sprendimai leidžia operatyviai reaguoti į rinkos pokyčius ir koreguoti atsargų strategijas. Dashboard tipo vizualizacijos įrankiai padeda vadovams greitai identifikuoti problemas ir priimti pagrįstus sprendimus. Tokių sistemų diegimas gali sutrumpinti sprendimų priėmimo laiką 40-50 procentų.

Statistikos duomenų analizė Ford dalių rinkoje atskleidžia ne tik esamus vartotojų poreikių modelius, bet ir formuoja strateginio planavimo pagrindą ateities iššūkiams. Technologijų plėtra, vartotojų elgsenos pokyčiai ir rinkos dinamika reikalauja nuolatinio analitinių metodų tobulinimo ir prisitaikymo prie kintančių sąlygų. Organizacijos, sugebančios efektyviai integruoti duomenų analizę į atsargų valdymo procesus, įgyja konkurencinį pranašumą ir užtikrina ilgalaikį verslo tvarumą. Ateities sėkmė priklausys nuo gebėjimo derinti tradicinius verslo principus su pažangiomis analitikos technologijomis, formuojant adaptyvų ir efektyvų atsargų valdymo modelį.

Statistikos naujienų skaitymo gidas: kaip atskirti patikimus duomenis nuo manipuliacijų

Posted on 16 rugsėjo, 2025 By www.statisticsjournal.lt
Statistikos naujienų skaitymo gidas: kaip atskirti patikimus duomenis nuo manipuliacijų
Faktai, Patarimai

Kiekvieną savaitę pro akis prabėga dešimtys skaičių: nedarbo procentai, infliacijos rodikliai, apklausų rezultatai, sveikatos statistikos. Dauguma jų priimami be didesnio abejojimo – juk skaičius atrodo objektyviai, sausai, sunkiai užginčijamai. Bet būtent tas objektyvumo įspūdis dažnai ir yra problema. Skaičius pats savaime nemeluoja, tačiau būdas, kuriuo jis pateikiamas, gali pasakyti visai kitą istoriją nei ta, kurią rodo tikrovė.

Kai procentas pasako mažiau, nei atrodo

Vienas dažniausių triukų – santykinio ir absoliutaus dydžio painiava. Antraštė skelbia, kad tam tikros ligos rizika išaugo 50 procentų. Skamba gąsdinančiai, kol nepažiūri, kad rizika padidėjo nuo 0,002 iki 0,003 procento. Matematiškai teisinga, emociškai – klaidinanti. Tas pats principas galioja ir ekonomikoje: pareiškimas, kad kainos „pakilo dvigubai lėčiau nei pernai“, nieko nepasako apie tai, ar jos apskritai kyla, ar kartais net krenta.

Verta įprasti klausti ne „kiek procentų“, o „procentų nuo ko“. Be bazinio skaičiaus procentinis pokytis yra tuščias.

Imties dydis ir tyliai nuleistos detalės

Apklausa, kurioje dalyvavo 400 žmonių, ir apklausa su 4000 respondentų statistiškai turi labai skirtingą patikimumo lygį, tačiau žiniasklaidoje dažnai pateikiamos vienodai autoritetingai. Dar rečiau paminima, kaip buvo formuojama imtis – ar respondentai atsitiktiniai, ar tai savanoriškai užpildyta internetinė anketa, kurią linkę pildyti tik tie, kas turi stiprią nuomonę. Toks metodologinis skirtumas gali lemti visiškai priešingas išvadas iš, atrodytų, panašių tyrimų.

Praktiškas patarimas: jei straipsnyje minimas tyrimas ar apklausa, verta paieškoti originalaus šaltinio. Dažnai paaiškėja, kad žiniasklaidos antraštė ištraukė vieną skaičių iš konteksto, ignoruodama likusią, kur kas sudėtingesnę tyrimo dalį.

Koreliacija dėvi priežastingumo kaukę

Tai, ko gero, seniausias statistikos manipuliavimo būdas, ir vis dėlto jis veikia nuolat. Du reiškiniai kinta kartu – ledų pardavimai ir nuo karščio kylantys skendimo atvejai – bet tai nereiškia, kad vienas sukelia kitą. Abu paprasčiausiai susiję su trečiuoju veiksniu, šiuo atveju karščiu. Rimtesniuose kontekstuose ši klaida tampa pavojingesnė: kai politikos ar sveikatos sprendimai grindžiami koreliacija, kuri iš tikrųjų yra atsitiktinė arba priklauso nuo nepastebėto tarpinio kintamojo.

Sveika taisyklė – kaskart, kai matote frazę „tyrimas parodė ryšį“, patikrinti, ar tekste bent bandoma paaiškinti mechanizmą, kodėl vienas dalykas veiktų kitą. Jei paaiškinimo nėra, tikėtina, kad ir patys tyrėjai neturi pakankamai duomenų teigti priežastingumą.

Grafikų geometrija: kaip ašis pakeičia istoriją

Vizualizacijos dažnai manipuliuoja subtiliau nei tekstas. Nutrūkusi y ašis gali paversti nereikšmingą 2 procentų svyravimą į dramatišką šuolį. Pasirinktas laikotarpis – pavyzdžiui, palyginimas su itin žemu ar itin aukštu tašku praeityje – gali sukurti įspūdį apie tendenciją, kurios iš tikrųjų nėra. Verta įsivertinti, ar grafiko skalė prasideda nuo nulio, ir ar laikotarpis, kuris rodomas, yra reprezentatyvus, ar tiesiog patogiai parinktas argumentui pagrįsti.

Kas užsako duomenis

Retai kada straipsnyje pabrėžiama, kas finansavo tyrimą. Farmacijos kompanijos užsakytas tyrimas apie savo produkto veiksmingumą, pramonės asociacijos finansuota apklausa apie reguliavimo poveikį – tai nebūtinai reiškia, kad duomenys suklastoti, bet interesų konfliktas turėtų kelti papildomą atidumą. Skaidrūs tyrimai paprastai nurodo finansavimo šaltinį ir metodologiją atskirame priede; jei tokios informacijos rasti nepavyksta, tai savaime yra signalas.

Skaičiai kaip veidrodis, o ne kaip nuosprendis

Statistika iš esmės yra įrankis suprasti pasaulį, ne baigtinis argumentas jį uždaryti. Kiekvienas skaičius atspindi tam tikrą metodą, tam tikrą imtį, tam tikrą laiko momentą – ir visa tai formuoja, ką tas skaičius iš tikrųjų reiškia. Skaitant naujienas su duomenimis, verta ne atmesti skaičius kaip nepatikimus a priori, bet elgtis su jais kaip su liudytojo parodymais teisme: klausti, iš kur informacija, kas ją rinko, kokiu tikslu ir ką ji nutyli. Tas, kas įpranta užduoti šiuos klausimus automatiškai, nustoja būti pasyviu skaičių vartotoju ir tampa žmogumi, kuris skaito tarp eilučių – ten, kur dažniausiai ir slypi tikroji istorija.

Kaip skaityti statistinius duomenis ir nepasiduoti klaidinančioms interpretacijoms

Posted on 19 rugpjūčio, 2025 By www.statisticsjournal.lt
Kaip skaityti statistinius duomenis ir nepasiduoti klaidinančioms interpretacijoms
Faktai, Patarimai

Statistika – draugas ar priešas?

Žinote tą jausmą, kai matote kokį nors antraštę tipo „80% žmonių sutinka su X” ir galvojate – oho, tai rimtas argumentas? O paskui pasirodo, kad tą tyrimą atliko pati kompanija, kuri parduoda X, ir apklausė 15 savo darbuotojų. Statistika yra nuostabi, kai ji naudojama sąžiningai, bet ji taip pat gali būti vienas iš galingiausių manipuliacijos įrankių, kokius žmonija išrado.

Gera žinia – suprasti, kada esi apgaudinėjamas, nėra taip sunku, kaip atrodo. Nereikia būti matematikos genijumi. Reikia tiesiog žinoti, į ką žiūrėti.

Imtis – viskas prasideda čia

Pirmasis klausimas, kurį turėtum užduoti matydamas bet kokį tyrimą: kiek žmonių buvo apklausta ir kas jie tokie? Tai skamba elementariai, bet dauguma žmonių šį žingsnį praleidžia.

Jei tyrimas sako, kad „trys iš keturių gydytojų rekomenduoja šį produktą” – tai reiškia, kad galbūt buvo apklausta tik keturi gydytojai. Ir gal tie keturi buvo parinkti neatsitiktinai. Imtis turi būti pakankamai didelė ir reprezentatyvi – tai yra, ji turi atspindėti visą populiaciją, apie kurią kalbama, o ne tik patogią jos dalį.

Kitas dalykas – kaip žmonės buvo atrinkti. Jei apklausa vykdoma internete ir žmonės patys renkasi dalyvauti, rezultatai bus iškreipti. Aktyviau dalyvauja tie, kuriems tema svarbi arba kurie turi stiprią nuomonę. Tai vadinama saviatrankos šališkumu, ir jis gali visiškai išversti tyrimą aukštyn kojomis.

Procentai be konteksto – klasikinė apgavystė

„Rizika išaugo 100%!” – skamba baisiai, tiesa? Bet jei pradinė rizika buvo 0,001%, tai dabar ji yra 0,002%. Vis dar labai maža. Šis triukas vadinamas santykiniu rizikos padidėjimu, ir jis naudojamas nuolat – ypač farmacijos reklamose ir sensacingose žiniasklaidos antraštėse.

Todėl visada ieškokite absoliučių skaičių. Jei kažkas sako „išaugo 50%”, klauskite – nuo ko iki ko? Kiek tai reiškia realiais žmonėmis ar atvejais? Kontekstas keičia viską.

Dar vienas mėgstamas triukas – vidurkis vietoj medianų. Tarkime, penkiems žmonėms uždirba 1000, 1000, 1000, 1000 ir 100 000 eurų. Vidurkis bus 20 800 eurų – skaičius, kuris neatspindi nė vieno realaus žmogaus situacijos. Mediana (vidurinė reikšmė) būtų 1000 eurų – daug tiksliau. Kai kalbama apie pajamas, turto pasiskirstymą ar kainas, visada klauskite: ar čia vidurkis, ar mediana?

Koreliacija – ne tas pats, kas priežastingumas

Tai tikriausiai labiausiai išnaudojamas statistinis nesusipratimas. Du dalykai gali vykti vienu metu ir neturėti nieko bendra tarpusavyje. Ledų pardavimai vasarą išauga. Nuskaндimų skaičius vasarą taip pat išauga. Ar ledai žudo? Žinoma, ne – abu reiškiniai tiesiog susiję su vasara ir karštu oru.

Kai matote teiginį „X žmonės, kurie daro Y, gyvena ilgiau” – tai dar nereiškia, kad Y yra priežastis. Galbūt žmonės, kurie daro Y, taip pat turi daugiau pinigų, geriau maitinasi, mažiau stresauja. Galbūt Y yra tik simptomas, o ne priežastis. Šie paslėpti veiksniai vadinami trikdančiais kintamaisiais, ir jie gali paversti bet kokį tyrimą beprasmiu, jei į juos neatsižvelgiama.

Grafikai, kurie meluoja tiesą sakydami

Vizualizacijos – tai atskiras menas klaidinti. Vienas klasikiausių triukų – Y ašies manipuliacija. Jei grafikas pradedamas ne nuo nulio, net mažas pokytis atrodo kaip dramatiškas šuolis. Kompanijos tai daro nuolat, rodydamos savo akcijų augimą ar produkto populiarumą.

Taip pat atkreipkite dėmesį į laiko ašį. Jei rodomas augimas per pastaruosius tris mėnesius, bet prieš tai buvo penkerių metų kritimas – tai labai selektyvi tiesa. Visada klauskite, koks yra platesnis kontekstas ir kodėl pasirinktas būtent toks laikotarpis.

Kai statistika tampa gyvenimo įgūdžiu

Skaityti statistinius duomenis kritiškai – tai ne paranoja ir ne cinizmas. Tai tiesiog pagarba sau ir savo sprendimams. Kiekvieną dieną esame bombarduojami skaičiais – apie sveikatą, politiką, ekonomiką, produktus – ir dažniausiai kažkas tų skaičių parinko labai apgalvotai, norėdamas, kad galvotume tam tikru būdu.

Geriausias ginklas prieš tai – keli paprasti klausimai: Kas atliko tyrimą ir kodėl? Kiek žmonių dalyvavo ir kaip jie buvo atrinkti? Ar tai absoliutūs, ar santykiniai skaičiai? Ar koreliacija painiojama su priežastingumu? Ar grafikas vizualiai neklaidina? Šie klausimai nepavers jūsų statistiku, bet tikrai pavers žmogumi, kurio daug sunkiau apgauti. O tai, draugai, šiais laikais yra tikrai vertinga supergalia.

Kaip dirbtinis intelektas keičia statistikos rinkimo ir analizės metodus Lietuvoje

Posted on 9 rugpjūčio, 2025 By www.statisticsjournal.lt
Kaip dirbtinis intelektas keičia statistikos rinkimo ir analizės metodus Lietuvoje
Faktai, IT

Valstybės duomenų agentūra (buvęs Statistikos departamentas) kasmet apklausia tūkstančius namų ūkių ir įmonių, kad sudėliotų vaizdą apie infliaciją, nedarbą, gyventojų pajamas. Tai brangus ir lėtas procesas – apklausėjas skambina, žmogus atsako, duomenys suvedami, tikrinami, tik tada patenka į ataskaitą. Dirbtinis intelektas šį modelį jau pradeda ardyti, ir įdomu ne tai, kad technologija egzistuoja, o tai, kiek greitai ji prasiskverbia į institucijas, kurios tradiciškai keičiasi labai atsargiai.

Nuo klausimynų prie registrų

Didžiausias poslinkis vyksta ne pačioje analizėje, o duomenų šaltiniuose. Lietuva turi palyginti gerai sutvarkytus administracinius registrus – Sodros, VMI, Gyventojų registro tarnybos duomenų bazes. Vietoj to, kad klaustų žmonių apie pajamas, vis dažniau paprasčiausiai imami mokesčių administravimo duomenys. Dirbtinis intelektas čia atlieka nuobodų, bet svarbų darbą: sujungia skirtingų formatų įrašus, aptinka dublikatus, taiso neatitikimus tarp registrų, kurie realybėje niekada nesutampa idealiai.

Tai skamba techniškai nuobodžiai, tačiau pasekmės rimtos. Kai statistika remiasi registrais, o ne apklausomis, sumažėja atsakymo klaida – žmonės apklausose linkę meluoti apie pajamas ar alkoholio vartojimą. Bet atsiranda kita problema: registrai fiksuoja tik tai, kas oficialiai deklaruota. Šešėlinė ekonomika, kurios Lietuvoje vis dar nemažai, tokiu būdu tampa dar mažiau matoma.

Teksto analizė ten, kur anksčiau dirbo žmonės rankomis

Įdomus pavyzdys – ekonominės veiklos klasifikavimas. Kai įmonė registruojasi, ji turi nurodyti NACE kodą, apibūdinantį veiklos pobūdį. Anksčiau tai buvo pusiau rankinis darbas – tarnautojas skaitė verslo planą ar aprašymą ir spėdavo, koks kodas tinkamiausias. Dabar natūralios kalbos apdorojimo modeliai gali skaityti tūkstančius tokių aprašymų per sekundes ir pasiūlyti klasifikaciją, kurią žmogus tik patvirtina arba pataiso.

Panašiai naudojama ir skundų, apklausų atvirų klausimų, net socialinių tinklų įrašų analizė – bandant suprasti nuotaikas, kurios sunkiai pagaunamos standartiniais klausimynais. Vartotojų pasitikėjimo indeksas, pavyzdžiui, tradiciškai skaičiuojamas iš uždarų klausimų. Jei prie to pridedama teksto analizė iš viešų šaltinių, gaunamas šiek tiek kitoks, greitesnis, bet ir mažiau patikimas signalas.

Prognozavimas realiu laiku

Vienas iš dalykų, kurį DI keičia pastebimiausiai – tai vadinamasis „nowcasting“, arba dabartinės situacijos įvertinimas dar prieš oficialius duomenis. BVP skaičiai paprastai vėluoja mėnesiais. Mašininio mokymosi modeliai, maitinami elektros suvartojimo, mokėjimo kortelių operacijų, krovinių vežimo duomenimis, gali pateikti apytikslį BVP augimo įvertį dar prieš pasibaigiant ketvirčiui. Lietuvos bankas ir kai kurios analitinės institucijos jau eksperimentuoja su panašiais modeliais, nors viešai apie tai kalbama mažiau, nei vertėtų.

Čia verta stabtelėti ir paklausti – ar toks greitis tikrai reikalingas smulkiai valstybei? Didelėms ekonomikoms kelių savaičių paklaida turi realią kainą, nes nuo jos priklauso centrinio banko sprendimai. Lietuvos atveju nowcasting dažniau tarnauja kaip prestižinis projektas nei praktinis įrankis, bent jau kol kas.

Kur algoritmas pralaimi žmogui

Yra ir aiškios ribos. Maži imčių dydžiai – tipiška Lietuvos statistikos problema – mašininio mokymosi modeliams yra tiesiog nepatogūs. Dideli modeliai geriausiai veikia ten, kur duomenų yra daug, o mūsų šalyje net didžiausios apklausos apima kelis tūkstančius respondentų. Modelis, treniruotas tokiais kiekiais, linkęs „perprasti“ triukšmą kaip dėsningumą.

Be to, metodologinis skaidrumas – dalykas, kuriuo oficiali statistika tradiciškai didžiuojasi – sunkiai dera su sudėtingais mašininio mokymosi modeliais. Jei Eurostat ar tarptautiniai partneriai paklaus, kodėl skaičius toks, o ne kitoks, atsakymas „taip apskaičiavo neuroninis tinklas“ nėra priimtinas. Todėl dažniausiai naudojami paprastesni, aiškiau interpretuojami modeliai, net jei jie mažiau tikslūs.

Skaičiai, kurie dar mokosi vaikščioti

Sunku nuspėti, kaip greitai šie pokyčiai taps norma, o ne eksperimentu. Lietuvos institucijos, palyginti su didesnėmis valstybėmis, turi vieną pranašumą – mažesnę biurokratinę inerciją, todėl naujus įrankius kartais išbando greičiau nei kaimyninės šalys. Bet turi ir trūkumą – ribotus žmogiškuosius resursus tam, kad tuos įrankius prižiūrėtų kompetentingai, o ne tiesiog paleistų ir tikėtųsi, jog viskas susitvarkys savaime.

Realybė, matyt, bus nuobodesnė nei entuziastų pasakojimai ir mažiau dramatiška nei skeptikų baimės. Apklausėjas su telefonu dar ilgai neišnyks visai, bet vis daugiau darbo persikels į duomenų suderinimą, anomalijų paiešką ir modelių priežiūrą. Statistika Lietuvoje netaps automatiška savaime – ji taps kitokia, priklausančia nuo to, kiek žmonių supras, ką iš tikrųjų daro algoritmas, kurį jie naudoja.

Kaip skaityti statistinius duomenis ir nepasiduoti klaidinančioms interpretacijoms: praktinis vadovas

Posted on 7 rugpjūčio, 2025 By www.statisticsjournal.lt
Kaip skaityti statistinius duomenis ir nepasiduoti klaidinančioms interpretacijoms: praktinis vadovas
Faktai, Patarimai

Kodėl statistika taip lengvai apgauna

Turbūt esate matę antraštę tipo „Mokslininkai įrodė, kad kavos gėrėjai gyvena ilgiau”. Ir tikriausiai bent akimirką pagalvojote – gal reikėtų išgerti dar vieną puodelį? Štai čia prasideda problema. Statistika nėra melavimo įrankis, bet ji yra neįtikėtinai patogi priemonė klaidinti – ypač tuos, kurie neskiria laiko paskaityti smulkų šriftą.

Geros naujienos: norint suprasti, ar jums rodomi duomenys yra patikimi, nereikia būti matematiku. Reikia tik žinoti kelis pagrindinius dalykus.

Koreliacija nėra priežastingumas – ir tai nėra tik frazė

Tai bene dažniausiai kartojama statistikos taisyklė, bet žmonės vis tiek ją pamiršta, kai duomenys atrodo įtikinami. Pavyzdys iš realaus gyvenimo: tyrimai rodo, kad šalyse, kur vartojama daugiau šokolado, yra daugiau Nobelio premijos laureatų. Ar šokoladas daro žmones protingesnius? Žinoma, ne – tiesiog turtingesnės šalys tiek daugiau valgo šokolado, tiek turi geresnes mokslo institucijas.

Kai matote teiginį „X susijęs su Y”, visada paklauskite savęs: ar gali būti trečias veiksnys, kuris lemia abu? Dažniausiai – gali.

Absoliutūs ir santykiniai skaičiai – skirtumas, kuris keičia viską

Įsivaizduokite, kad vaistas sumažina vėžio riziką 50%. Skamba įspūdingai, tiesa? Bet jei pradinė rizika buvo 2 iš 1000, tai po vaisto ji tampa 1 iš 1000. Santykinis sumažėjimas – 50%. Absoliutus sumažėjimas – 0,1 procento punkto.

Farmacijos kompanijos, politikai ir žiniasklaida mėgsta naudoti tą skaičių, kuris atrodo įspūdingiausiai. Todėl visada verta paklausti: o koks buvo pradinis dydis? Be šio konteksto santykiniai skaičiai beveik nieko nesako.

Imties dydis ir reprezentatyvumas – du klausimai, kuriuos reikia užduoti iš karto

„Tyrimas su 12 dalyvių parodė…” – tokia antraštė turėtų iš karto sukelti įtarimą. Kuo mažesnė imtis, tuo didesnė tikimybė, kad rezultatai yra atsitiktiniai. Bet imties dydis nėra vienintelis dalykas.

Svarbu ir tai, kas buvo tiriama. Jei apklausa apie politines pažiūras buvo atlikta tik universiteto miestelyje, jos rezultatai tikrai neatspindi visos visuomenės. Reprezentatyvumas reiškia, kad tiriamoji grupė turi atspindėti tą populiaciją, apie kurią daromos išvados. Dažnai to nebūna.

Grafikai gali meluoti net nemelodami

Vienas klasikinių triukų – Y ašies manipuliacija. Jei grafikas prasideda ne nuo nulio, net nedidelis pokytis atrodo dramatiškas. Pavyzdžiui, jei akcijų kaina pakilo nuo 98 iki 102 eurų, bet grafikas rodo ašį nuo 95 iki 105, linija atrodo kaip stačias šuolis į viršų.

Kitas dalykas – spalvos ir proporcijos skritulinėse diagramose, kurios kartais vizualiai iškreipiamos. Prieš darydami išvadas iš grafiko, pažiūrėkite į skaičius po juo. Jie pasakys daugiau nei bet kokia linija.

Kai skaičiai tampa įrankiu, o ne tiesa

Statistika pati savaime nėra nei gera, nei bloga – ji yra tiek pat patikima, kiek patikimi žmonės, kurie ją renka, interpretuoja ir pateikia. Todėl svarbiausia įprotis, kurį galite susiformuoti, yra paprastas: nesustokite ties antrašte. Paklauskite, kas atliko tyrimą ir kas jį finansavo. Paklauskite, kiek žmonių buvo tiriama ir kaip jie buvo parinkti. Paklauskite, ar kalbama apie absoliučius, ar santykinius skaičius.

Tai nėra cinizmas ar nepasitikėjimas mokslu – tai elementarus kritinis mąstymas, kurio statistika tiesiog reikalauja. Ir kuo dažniau užduosite šiuos klausimus, tuo sunkiau bus jus suklaidinti – nesvarbu, ar tai darytų žiniasklaida, politikai, ar net geranoriški mokslininkai, kurie tiesiog perdėtai optimistiškai interpretavo savo rezultatus.

Kaip statistikos duomenys atskleidžia tikrąją Lietuvos gyventojų sveikatos būklę: 10 skaičių, kurie verčia susimąstyti

Posted on 25 liepos, 2025 By www.statisticsjournal.lt
Kaip statistikos duomenys atskleidžia tikrąją Lietuvos gyventojų sveikatos būklę: 10 skaičių, kurie verčia susimąstyti
Faktai

Kartais užtenka pažvelgti į vieną lentelę su skaičiais, kad suprastum daugiau nei perskaitęs dešimt straipsnių apie sveikatą. Lietuvos statistikos departamento ir Higienos instituto duomenys kasmet piešia gan tikslų paveikslą – ir jis ne visada malonus. Bet būtent nepatogūs skaičiai dažniausiai ir yra tie, kurie verčia susimąstyti bei ką nors keisti. Pažiūrėkime į dešimt skaičių, kurie apie mūsų sveikatą pasako kur kas daugiau, nei norėtųsi tikėtis.

1. Vidutinė gyvenimo trukmė – vis dar atsiliekame

Lietuvoje vidutinė gyvenimo trukmė svyruoja apie 75–76 metus, kai Vakarų Europoje ši riba dažnai peržengia 80 metų. Skirtumas nėra mažas – tai beveik penkeri metai gyvenimo, kurių lietuviai vidutiniškai netenka. Ir čia svarbu ne tik pati skaitmena, bet ir tai, kad atotrūkis mažėja lėtai, nepaisant medicinos pažangos.

2. Vyrai gyvena beveik 10 metų trumpiau nei moterys

Tai vienas ryškiausių Lietuvos rodiklių Europos kontekste. Vyrų ir moterų gyvenimo trukmės skirtumas siekia apie 9–10 metų, kai daugelyje ES šalių jis neviršija 5–6 metų. Priežastys žinomos – alkoholis, rūkymas, traumos, vėlyvas kreipimasis į gydytojus. Bet žinojimas ir sprendimas, deja, ne tas pats.

3. Beveik trečdalis suaugusiųjų turi antsvorio problemų

Apie 60 proc. suaugusių gyventojų turi antsvorį arba nutukimą, o iš jų reikšminga dalis – jau su nutukimu, ne tik keliais papildomais kilogramais. Tai reiškia, kad didžioji dalis visuomenės gyvena su padidėjusia rizika susirgti diabetu, širdies ligomis ar sąnarių problemomis, dažnai to nė nesuvokdama.

4. Širdies ir kraujagyslių ligos – vis dar mirties priežastis numeris vienas

Daugiau nei pusė visų mirčių Lietuvoje susijusios su širdies ir kraujagyslių sistemos ligomis. Tai skaičius, kuris nesikeičia jau dešimtmečius, nors profilaktikos priemonių ir informacijos apie sveiką gyvenseną tikrai netrūksta. Klausimas – kodėl žinios neišsiverčia į veiksmus?

5. Alkoholio suvartojimas – vienas didžiausių ES

Nors per pastarąjį dešimtmetį alkoholio suvartojimas sumažėjo, Lietuva vis dar patenka tarp lyderių ES pagal suvartojamą kiekį vienam gyventojui per metus. Skaičius apie 10–11 litrų gryno alkoholio metams reiškia ne tik sveikatos, bet ir socialines pasekmes – nuo šeimos problemų iki nelaimingų atsitikimų keliuose.

6. Savižudybių rodiklis – skaudžiausia statistika

Lietuva ilgą laiką pirmavo Europoje pagal savižudybių skaičių. Nors pastaraisiais metais rodiklis mažėja, jis vis dar išlieka vienas aukščiausių žemyne. Tai skaičius, už kurio slypi ne abstrakti statistika, o konkretūs žmonės, šeimos, bendruomenės, kurios liko be atsakymų.

7. Tik apie pusė gyventojų reguliariai tikrinasi sveikatą

Prevencinių patikrų dalyvavimo rodikliai – tarkim, gimdos kaklelio ar krūties vėžio patikrose – dažnai nesiekia net pusės tikslinės grupės. O juk tai patikros, kurios gali išgelbėti gyvybę, aptikus ligą ankstyvoje stadijoje. Kodėl žmonės vengia? Dažniausiai – baimė, laiko stoka arba tiesiog įprotis atidėlioti.

8. Rūkymas mažėja, bet ne taip greitai, kaip norėtųsi

Rūkančiųjų dalis tarp suaugusiųjų sumažėjo iki maždaug 25 proc., tačiau tai vis dar reiškia, kad kas ketvirtas gyventojas reguliariai rūko. Įdomu tai, kad jaunimo tarpe elektroninių cigarečių populiarumas auga sparčiau, nei mažėja tradicinio rūkymo paplitimas – tad bendras vaizdas nebūtinai toks šviesus, koks atrodo iš pirmo žvilgsnio.

9. Psichikos sveikatos problemos – vis dažniau įvardijamos, bet retai gydomos laiku

Apie 20 proc. gyventojų per metus patiria bent vieną psichikos sveikatos sutrikimą, tačiau tik nedidelė dalis kreipiasi profesionalios pagalbos. Statistika rodo augantį sąmoningumą – žmonės pradeda kalbėti apie tai atviriau, tačiau paslaugų prieinamumas ir stigma vis dar stabdo daugelį.

10. Sveikatos priežiūros išlaidos – auga, bet ne visada ten, kur reikia

Valstybės išlaidos sveikatai kasmet auga, tačiau didžioji dalis biudžeto keliauja į gydymą, o ne prevenciją. Tai skaičius, kuris netiesiogiai paaiškina, kodėl kiti devyni šio sąrašo skaičiai atrodo taip, kaip atrodo – sistema orientuota gesinti gaisrus, o ne jų neleisti kilti.

Kai skaičiai pradeda kalbėti

Statistika savaime nieko nepakeičia – ji tiesiog parodo veidrodį. Ir šis veidrodis sako gan aiškiai: Lietuvos gyventojų sveikata priklauso ne tik nuo medicinos sistemos, bet ir nuo kasdienių pasirinkimų, kuriuos darome patys – ką valgome, kiek judame, kaip elgiamės su stresu ir ar leidžiame sau laiku nueiti pas gydytoją. Dešimt skaičių, kuriuos aptarėme, nėra tik sausi faktai lentelėse. Tai realūs žmonės, jų sprendimai ir jų pasekmės, susumuotos vienoje ataskaitoje. Ir gal tikroji vertė šių skaičių ne ta, kad jie mus nuliūdina, o ta, kad jie duoda konkretų atspirties tašką – žinant, kur esame, lengviau suprasti, kur norime judėti toliau.

Vaikų sveikatos statistika Lietuvoje: kaip epidemiologiniai duomenys atskleidžia realią situaciją šalyje

Posted on 6 liepos, 2025 By www.statisticsjournal.lt
Vaikų sveikatos statistika Lietuvoje: kaip epidemiologiniai duomenys atskleidžia realią situaciją šalyje
Faktai, Pranešimai

Kodėl vaikų sveikatos skaičiai kartais meluoja, o kartais – šaukia pagalbos

Kai prieš kelis metus Sveikatos apsaugos ministerija paskelbė, kad vaikų sergamumas Lietuvoje didėja, daugelis tėvų susiraukė – juk vaikų ligoninėse eilės trumpėja, o mokyklose ligonių vis mažiau. Paradoksas? Ne visai. Tiesiog epidemiologiniai duomenys – tai ne vien sausas skaičių rinkinys, o sudėtingas galvosūkis, kurį reikia mokėti perskaityti.

Lietuvoje vaikų sveikatos statistika renkami iš kelių šaltinių: pirminės asmens sveikatos priežiūros įstaigų, ligoninių, profilaktinių patikrinimų duomenų bazių ir įvairių registrų. Problema ta, kad šie duomenys ne visada atspindi tikrąją situaciją. Pavyzdžiui, jei šeimos gydytojai pradeda aktyviau diagnozuoti tam tikras ligas ar būkles, statistikoje tai atrodo kaip sergamumo augimas, nors iš tikrųjų tiesiog geriau atpažįstamos anksčiau nepastebėtos problemos.

Ką slepia diagnozių kodai ir registracijos knygos

Epidemiologinė statistika Lietuvoje remiasi Tarptautine ligų klasifikacija (TLK-10), kur kiekviena liga ar būklė turi savo kodą. Teoriškai tai turėtų užtikrinti tikslumą, bet praktikoje dažnai susidaro keistos situacijos. Vienas gydytojas alergijos simptomus užkoduoja kaip „J30.4 – alerginį rinitą”, kitas – kaip „R06.7 – čiaudulį”, o trečias išvis neregistruoja, jei simptomas nesunkus.

Dar įdomiau su psichikos sveikata. Lietuvoje oficialiai registruotų vaikų su depresija ar nerimo sutrikimais skaičius gerokai mažesnis nei Vakarų Europoje. Ar tai reiškia, kad mūsų vaikai psichiškai sveikesni? Deja, ne. Tiesiog daugelis tėvų vis dar bijo kreiptis į psichikos sveikatos specialistus, o kai kurie gydytojai vengia „klijuoti etiketes” vaikams. Rezultatas – statistika nerodo tikrosios situacijos.

Vakcinacijos duomenys: kur tiesa, o kur tik popierius

Vakcinacijos rodikliai – viena iš sričių, kur Lietuva atrodo gana gerai. Oficiali statistika rodo, kad apie 95 procentai vaikų yra paskiepyti pagal nacionalinį kalendorių. Tačiau kai kurie epidemiologai įspėja: šie skaičiai gali būti šiek tiek „pagražinti”.

Problema slypi sistemoje. Kartais vaikai paskiepijami, bet duomenys neįvedami į elektroninę sistemą laiku. Kartais, atvirkščiai – įvedami duomenys apie skiepus, kurie faktiškai atidėti dėl medicininių priežasčių. Dar sudėtingiau su vaikais, kurių šeimos dažnai keičia gyvenamąją vietą ar gydytojus – jų vakcinacijos istorija kartais „pasimeta” tarp įstaigų.

Realybė tokia: tikslus paskiepytų vaikų skaičius gali skirtis nuo oficialaus 2-3 procentiniais punktais. Gali atrodyti nedaug, bet kalbant apie bandinio imunitetą, tai gali būti kritinis skirtumas, ypač tokių užkrečiamų ligų kaip tymai ar kokliušas atveju.

Lėtinės ligos: kodėl astma „auga”, o cukrinis diabetas „stabilizuojasi”

Pažvelgus į pastarųjų dešimtmečių statistiką, matyti aiškus astma sergančių vaikų skaičiaus augimas. Prieš 20 metų Lietuvoje astma buvo diagnozuota maždaug 3 procentams vaikų, dabar – jau 7-8 procentams. Ar tai tikrai reiškia epidemiją?

Iš dalies – taip. Aplinkos tarša, gyvenimo būdo pokyčiai, mažesnis kontaktas su gamta ir mikroorganizmais tikrai prisideda prie alerginių ligų augimo. Bet ne mažiau svarbu tai, kad šiandien gydytojai tiesiog geriau atpažįsta astmą. Anksčiau vaikas, kuris dažnai kosėdavo ir švokšdavo, būdavo gydomas nuo „lėtinio bronchito” ar „dažnų peršalimų”. Dabar tas pats vaikas gauna tikslią astmos diagnozę ir tinkamą gydymą.

Su cukriniu diabetu situacija kitokia. I tipo cukrinio diabeto atvejų skaičius Lietuvoje išlieka gana stabilus – apie 20-25 nauji atvejai 100 tūkstančių vaikų per metus. Čia statistika greičiausiai atspindi realybę tiksliai, nes šios ligos neįmanoma nepastebi ar „neužregistruoti” – simptomai per daug ryškūs, o diagnozė paprastai nustatoma ligoninėje.

Nutukimas ir metabolinės problemos: statistika, kuri gąsdina

Viena iš labiausiai neramią keliančių tendencijų – vaikų nutukimo statistika. Pagal oficialius duomenis, Lietuvoje antsvoris ar nutukimas yra maždaug 15-18 procentų vaikų. Tačiau kai kurie nepriklausomi tyrimai rodo dar liūdnesnius skaičius – iki 25 procentų.

Kodėl toks neatitikimas? Pirma, ne visi vaikai reguliariai lankosi pas gydytojus, todėl jų svoris nefiksuojamas. Antra, skirtingose įstaigose naudojami skirtingi nutukimo vertinimo kriterijai. Trečia – ir tai gal svarbiausia – nutukimas dažnai neužkoduojamas kaip atskira diagnozė, jei vaikas kreipiasi dėl kitos problemos.

Dar sudėtingiau su metaboliniu sindromu ir insulino rezistencija. Šios būklės vaikams Lietuvoje diagnozuojamos retai, nors specialistai įspėja, kad problema gerokai platesnė nei rodo statistika. Daugelis šeimos gydytojų tiesiog neturi galimybių ar laiko atlikti reikiamus tyrimus – reikia ne tik pasverti vaiką, bet ir ištirti kraują, įvertinti kelis rodiklius.

Traumos ir nelaimingi atsitikimai: ką slepia skubiosios pagalbos duomenys

Vaikų traumų statistika Lietuvoje rodo mažėjančią tendenciją – per pastaruosius 10 metų sunkių traumų sumažėjo maždaug 30 procentų. Puiku, ar ne? Bet pasižiūrėjus giliau, vaizdas tampa sudėtingesnis.

Tiesa ta, kad sunkių traumų – kaukolės lūžių, vidaus organų sužalojimų – tikrai sumažėjo. Čia didelį vaidmenį suvaidino geresnė vaikų priežiūra, saugesnės žaidimų aikštelės, automobilių saugos diržai ir kėdutės. Bet lengvesnių traumų – įsipjovimų, išsinardinimų, sumušimų – statistika ne visada patikima.

Problema ta, kad ne visos lengvos traumos registruojamos. Jei mama su vaiku atvažiuoja į skubią pagalbą dėl įsipjovusio piršto, o gydytojas tik užklijuoja pleistrą ir paleidžia namo – šis atvejis gali būti užregistruotas, o gali ir ne, priklausomai nuo įstaigos tvarkos ir gydytojo kruopštumo. Todėl tikrasis lengvų traumų skaičius gali būti 20-30 procentų didesnis nei rodo oficiali statistika.

Psichikos sveikata: didžiausia statistikos „juodoji skylė”

Jei yra viena sritis, kur Lietuvos vaikų sveikatos statistika labiausiai nutolusi nuo realybės – tai psichikos sveikata. Oficialūs duomenys rodo, kad psichikos sutrikimų turi apie 5-7 procentai vaikų. Bet tarptautiniai tyrimai rodo, kad realus skaičius turėtų būti 15-20 procentų.

Kodėl toks milžiniškas atotrūkis? Priežasčių keletas. Pirma, stigma – daugelis tėvų vis dar mano, kad kreiptis į psichologą ar psichiatrą reiškia pripažinti, jog su jų vaiku „kažkas ne taip”. Antra, nepakankamas specialistų skaičius – net norint gauti konsultaciją, reikia laukti kelis mėnesius. Trečia, diagnozavimo sunkumai – daugelis psichikos sutrikimų vaikystėje pasireiškia neaiškiais simptomais, kurie gali būti palaikyti tiesiog „sunkiu charakteriu” ar „pereinamuoju amžiumi”.

Ypač blogai atsispindi statistikoje nerimo sutrikimai, lengvos ir vidutinės depresijos, elgesio problemos. Dažnai šie vaikai apskritai nepatenka į sveikatos priežiūros sistemą – jų problemos sprendžiamos (ar nesprendžiamos) šeimoje, mokykloje, socialinių tarnybų.

Kaip skaityti tarp statistikos eilučių ir ką daryti su šia informacija

Supratę, kad epidemiologinė statistika – tai tik vienas realybės atspindys, o ne pati realybė, galime išmokti ją naudoti protingai. Tėvams svarbu suprasti: jei jūsų vaikas turi kokią nors sveikatos problemą, tai, kad ji „reta pagal statistiką”, nereiškia, kad ji nereali ar nereikšminga. Atvirkščiai – galbūt ji tiesiog nepakankamai diagnozuojama.

Sveikatos politikos formuotojams svarbu žiūrėti ne tik į oficialius skaičius, bet ir į tai, kas už jų slypi. Jei sergamumo tam tikra liga statistika auga – gal tai ne epidemija, o gerėjantis diagnozavimas? Jei, atvirkščiai, skaičiai stabilūs, kai tarptautiniai tyrimai rodo augimą – gal mūsų sistema kažko „nemato”?

Gydytojams ir kitiems specialistams svarbu kruopščiai registruoti duomenis. Taip, tai užima laiko, bet tik turėdami tikslią statistiką galime planuoti prevenciją, skirti išteklius, vertinti intervencijų efektyvumą.

Praktiškai kiekvienam iš mūsų tai reiškia: būkite savo vaikų sveikatos advokatai. Jei pastebite problemą – kreipkitės į specialistus, net jei aplinkui visi sako, kad „viskas gerai”. Jei gydytojas atmeta jūsų nuogąstavimus remdamasis tuo, kad „tai reta” – ieškokite kitos nuomonės. Statistika gali būti naudinga priemonė, bet ji neturi tapti kliūtimi individualiam požiūriui į kiekvieno vaiko sveikatą.

Galiausiai, verta prisiminti, kad už kiekvieno skaičiaus slypi konkretus vaikas su savo istorija. Epidemiologija padeda matyti bendrus vaizdus, tendencijas, rizikos veiksnius. Bet ji niekada nepakeis atidaus, rūpestingo požiūrio į kiekvieną atskirą mažąjį pacientą. Ir gal būt tai – svarbiausia pamoka, kurią galime išmokti iš vaikų sveikatos statistikos labirinto.

Kaip automatiniai internetiniai teksto vertėjai iškraipo statistinius duomenis ir kaip tai interpretuoti teisingai

Posted on 23 birželio, 2025 By www.statisticsjournal.lt
Kaip automatiniai internetiniai teksto vertėjai iškraipo statistinius duomenis ir kaip tai interpretuoti teisingai
Faktai, IT, Kalbos, Patarimai

Vertimo problema, apie kurią retai kalbama

Statistiniai duomenys yra vienas jautriausių turinio tipų, kurį galima pateikti automatiniam vertėjui. Skaičiai atrodo neutralūs, bet kontekstas, kuriame jie pateikiami, yra viskas. Kai „Google Translate”, „DeepL” ar bet kuris kitas automatinis įrankis verčia tekstą su procentais, santykiniais rodikliais ar sudėtingomis statistinėmis sąvokomis, rezultatas dažnai būna ne tik netikslus – jis gali būti tiesiogiai klaidinantis. Ir tai nėra smulkmena, kurią galima ignoruoti.

Problema egzistuoja keliais lygmenimis. Pirma, yra grynai kalbinis lygmuo – kai terminai verčiami pažodžiui, bet jų reikšmė skirtingose kalbose skiriasi. Antra, yra kultūrinis lygmuo – kai statistiniai duomenys yra susiję su konkrečia šalies sistema, ir vertimas neperteikia tos sistemos specifikos. Trečia, yra struktūrinis lygmuo – kai sakinio konstrukcija verčiama taip, kad priežasties ir pasekmės ryšys apsiverčia arba išnyksta. Kiekvienas iš šių lygmenų gali pakenkti duomenų interpretacijai, o visi trys kartu – tai jau tikra katastrofa analitikui, kuris remiasi verstu tekstu.

Kaip automatiniai vertėjai „supranta” skaičius

Automatiniai vertimo įrankiai, pagrįsti neuroniniais tinklais, iš esmės mokosi iš didelių tekstų korpusų. Jie nėra suprogramuoti suprasti statistiką – jie atpažįsta kalbos modelius ir bando juos atkartoti kitoje kalboje. Tai reiškia, kad kai vertėjas susiduria su fraze „the unemployment rate fell by 3 percentage points”, jis gali ją išversti kaip „nedarbo lygis sumažėjo 3 procentais” – ir tai yra esminis skirtumas.

Procentiniai punktai ir procentai nėra tas pats. Jei nedarbo lygis buvo 10 proc. ir sumažėjo 3 procentiniais punktais, dabar jis yra 7 proc. Bet jei sumažėjo 3 proc., tai reiškia, kad jis sumažėjo nuo 10 proc. iki 9,7 proc. Skirtumas – 0,3 procentinio punkto – gali atrodyti nedidelis, bet ekonominėje analizėje tai gali reikšti skirtingą politikos vertinimą, skirtingus biudžeto sprendimus ir skirtingas prognozes.

„DeepL” šiuo atžvilgiu veikia geriau nei „Google Translate” daugeliu atvejų, bet nė vienas iš jų nėra patikimas, kai kalbama apie statistinius niuansus. Tyrimai, kuriuose buvo lyginami automatiniai vertimai su profesionaliais vertimais medicinos ir ekonomikos srityse, nuolat rodo, kad automatiniai įrankiai daro sistemingas klaidas būtent ten, kur tikslumas yra kritiškiausias.

Terminologijos spąstai statistiniuose tekstuose

Statistinė terminologija yra ypač problematiška dėl kelių priežasčių. Daugelis terminų turi labai specifines reikšmes, kurios skiriasi nuo kasdienės kalbos vartosenos. „Significant” anglų kalboje statistiniame kontekste reiškia „statistiškai reikšmingas” – tai yra konkretus techninis terminas, susijęs su p reikšme ir hipotezių tikrinimo procedūromis. Automatinis vertėjas dažnai išverčia šį žodį kaip „reikšmingas” arba „svarbus”, kas yra teisingas vertimas kasdienine prasme, bet praranda statistinę specifiką.

Panašiai yra su tokiais terminais kaip „confidence interval” (pasikliautinasis intervalas), „standard deviation” (standartinis nuokrypis), „regression to the mean” (regresija į vidurkį) ar „correlation” (koreliacija). Kai šie terminai verčiami pažodžiui arba netiksliai, skaitytojas gali susidaryti visiškai klaidingą supratimą apie tai, ką tyrimas iš tikrųjų teigia.

Konkrečiai – „regression to the mean” lietuviškai turėtų būti verčiama kaip „regresija į vidurkį”, bet automatinis vertėjas kartais pateikia „grįžimas prie vidutinio” arba net „regresija į vidurį”, kas skamba nenatūraliai ir gali suklaidinti skaitytoją, nesusipažinusį su statistika. Dar blogiau, kai vertimas pateikia „atsitraukimas į vidurkį” – tai jau perteikia klaidingą kryptingumo pojūtį.

Praktinis patarimas: jei dirbate su statistiniais tekstais ir naudojate automatinį vertėją, sudarykite terminų žodyną prieš pradėdami darbą. Identifikuokite kiekvieną techninį terminą originale ir patikrinkite, kaip jis turėtų būti išverstas pagal oficialius statistikos standartus jūsų šalyje. Lietuvos statistikos departamentas ir Europos statistikos biuras (Eurostat) turi oficialius terminų žodynus, kurie turėtų būti pirminiai šaltiniai.

Kultūrinis kontekstas, kurį vertėjas neperteikia

Statistiniai duomenys visada egzistuoja konkrečiame institucininiame ir kultūriniame kontekste. Kai JAV ataskaita kalba apie „poverty line” (skurdo ribą), ji remiasi JAV federaline skurdo apibrėžtimi, kuri skiriasi nuo Europos Sąjungos naudojamos metodologijos. Kai automatinis vertėjas išverčia šią frazę kaip „skurdo riba”, skaitytojas lietuviškai gali manyti, kad kalbama apie tą pačią sąvoką, kurią naudoja Lietuvos statistikos departamentas – bet taip nėra.

JAV skurdo riba yra absoliutus rodiklis, apskaičiuojamas pagal minimalius pragyvenimo poreikius. ES naudoja santykinį rodiklį – 60 proc. medianos pajamų. Tai reiškia, kad palyginimas tarp JAV ir ES skurdo statistikos yra metodologiškai problematiškas, ir automatinis vertimas šios problemos nesprendžia – jis ją slepia.

Tas pats galioja sveikatos statistikai. „Life expectancy at birth” (tikėtina gyvenimo trukmė gimus) ir „healthy life years” (sveiki gyvenimo metai) yra skirtingi rodikliai, bet automatinis vertimas ne visada aiškiai atskiria šias sąvokas. Kai Europos šalių sveikatos ataskaitos verčiamos automatiškai, šis skirtumas dažnai išnyksta, ir skaitytojas gauna sumaišytą vaizdą.

Rekomendacija: prieš interpretuodami bet kokius statistinius duomenis iš verstų šaltinių, visada patikrinkite, kokia metodologija buvo naudojama originaliame šaltinyje. Tai galima padaryti ieškant originalaus dokumento metodologinės dalies arba susisiekiant su duomenis paskelbusia institucija. Tai užtrunka papildomą laiką, bet apsaugo nuo fundamentalių interpretacijos klaidų.

Sakinio struktūra ir priežastingumo iškraipymas

Vienas subtiliausių, bet potencialiai pavojingiausių automatinio vertimo problemų yra sakinio struktūros iškraipymas, kuris keičia priežasties ir pasekmės ryšį. Statistiniuose tekstuose priežastingumas yra ypač svarbus – skirtumas tarp „A sukelia B” ir „A koreliuoja su B” yra esminis, bet automatinis vertėjas ne visada jį išlaiko.

Anglų kalbos konstrukcija „associated with” dažnai verčiama kaip „susijęs su”, kas yra teisingas vertimas, bet kartais vertėjas parenka aktyvesnę konstrukciją, kuri implikuoja priežastingumą. Pavyzdžiui, „smoking is associated with higher cancer rates” gali būti išversta kaip „rūkymas lemia didesnius vėžio rodiklius” – ir tai jau yra stipresnis teiginys nei originale.

Dar viena problema – sąlyginis sakinys. Anglų kalboje „if X, then Y” yra aiški sąlyginė konstrukcija. Bet kai vertėjas susiduria su sudėtingesnėmis statistinėmis sąlyginėmis frazėmis, pvz., „controlling for age and income, the effect of education on health outcomes was…” – vertimas dažnai tampa neaiškus arba netikslus. „Controlling for” yra statistinis terminas, reiškiantis „kontroliuojant kintamąjį”, bet automatinis vertėjas gali pateikti „kontroliuojant amžių ir pajamas” arba net „atsižvelgiant į amžių ir pajamas” – pastarasis vertimas yra silpnesnis ir ne visai tikslus.

Praktinis patarimas: kai skaitote verstą statistinį tekstą, atkreipkite ypatingą dėmesį į žodžius, kurie nurodo ryšio pobūdį – „sukelia”, „lemia”, „susijęs su”, „koreliuoja”. Jei kyla abejonių, patikrinkite originalų tekstą ir ieškokite, kokia buvo originali formuluotė. Šiuolaikiniai moksliniai straipsniai dažniausiai yra prieinami anglų kalba, todėl tai nėra sudėtinga.

Skaičių formatavimas ir regioniniai skirtumai

Tai gali atrodyti kaip smulkmena, bet skaičių formatavimas yra dar viena sritis, kurioje automatiniai vertėjai daro klaidas. Skirtingose šalyse naudojami skirtingi skaičių formatai – kai kuriose šalyse tūkstančių skiriamasis ženklas yra taškas, o dešimtainė dalis atskiriama kableliu (pvz., 1.000,50), kitose – atvirkščiai (1,000.50). Automatinis vertėjas ne visada koreguoja šiuos formatus pagal tikslinę kalbą.

Kai vokiečių kalba parašytame tekste yra skaičius „1.234,56″ ir jis verčiamas į anglų kalbą, idealiu atveju jis turėtų tapti „1,234.56″. Bet automatinis vertėjas dažnai palieka originalų formatą arba jį iškraipo. Jei skaitytojas neatpažįsta šio skirtumo, jis gali interpretuoti „1.234″ kaip vieną ir du šimtus trisdešimt keturis, o ne kaip tūkstantį du šimtus trisdešimt keturis.

Dar sudėtingiau yra su valiutomis. Kai statistinis tekstas pateikia duomenis vienoje valiutoje ir automatinis vertėjas juos palieka nepakeistus, skaitytojas gali nesuvokti, kad reikia atlikti valiutos konvertavimą. O jei vertėjas bando konvertuoti valiutas – tai dar blogiau, nes jis naudoja tam tikrą kursą, kuris gali būti pasenęs arba neatitikti to laikotarpio, apie kurį kalbama tekste.

Konkreti rekomendacija: visada patikrinkite skaičių formatą originaliame tekste ir tikslinėje kalboje. Jei dirbate su finansiniais ar ekonominiais duomenimis, įsitikinkite, kad valiutos ir jų kursai yra aiškiai nurodyti ir atitinka analizuojamą laikotarpį. Niekada neremkitės automatiškai konvertuotomis valiutomis be papildomo patikrinimo.

Kaip patikrinti verstų statistinių duomenų tikslumą

Yra keletas praktinių metodų, kurie padeda sumažinti automatinio vertimo klaidų poveikį statistinių duomenų interpretacijai. Pirmiausia, visada ieškokite originalaus šaltinio. Jei tekstas buvo paskelbtas tarptautinės organizacijos – Pasaulio banko, TVF, PSO, Eurostato – originali versija dažniausiai yra anglų kalba ir laisvai prieinama internete. Tai turėtų būti pirmasis žingsnis prieš remiantis verstu tekstu.

Antra, naudokite kryžminį tikrinimą. Jei statistinis teiginys verste atrodo neįtikėtinas arba prieštarauja jūsų žinioms, patikrinkite jį kitame šaltinyje. Statistiniai duomenys retai egzistuoja vakuume – paprastai yra keletas šaltinių, kurie pateikia panašius rodiklius, ir jų palyginimas gali atskleisti vertimo klaidas.

Trečia, jei turite galimybę, naudokite profesionalų vertimą arba bent jau profesionalų redagavimą po automatinio vertimo. Tai ypač svarbu, kai statistiniai duomenys bus naudojami priimant svarbius sprendimus – verslo, politikos ar mokslo srityse. Automatinis vertimas yra geras kaip pirminis žingsnis, bet ne kaip galutinis produktas.

Ketvirta, išmokite atpažinti dažniausias klaidas. Jei žinote, kad automatiniai vertėjai dažnai painioja procentinius punktus su procentais, galite tikslingai ieškoti šios klaidos verste tekste. Tai reikalauja tam tikrų statistinių žinių, bet net bazinis supratimas apie dažniausias problemas gali labai padėti.

Penkta, kai dirbate su dideliais duomenų kiekiais ir automatinis vertimas yra neišvengiamas, apsvarstykite galimybę naudoti specializuotus vertimo įrankius, pritaikytus konkrečiai sričiai. Kai kurios platformos siūlo domenui pritaikytus vertimo modelius, kurie buvo apmokyti su statistiniais ar moksliniais tekstais ir veikia tiksliau nei bendrieji modeliai.

Kai vertimas tampa dezinformacijos šaltiniu

Yra dar vienas aspektas, apie kurį verta kalbėti atvirai – automatinio vertimo klaidų politinis ir socialinis poveikis. Statistiniai duomenys dažnai naudojami viešose diskusijose, žiniasklaidoje ir politiniuose debatuose. Kai šie duomenys yra klaidingai išversti ir klaidinga interpretacija paplinta viešojoje erdvėje, tai gali turėti realių pasekmių.

Pavyzdys iš praktikos: migracijos statistika yra viena jautriausių temų, ir automatiniai vertimai šioje srityje daro ypač daug klaidų. Sąvokos kaip „net migration” (grynoji migracija), „asylum seekers” (prieglobsčio prašytojai), „refugees” (pabėgėliai) ir „irregular migrants” (neteisėti migrantai) turi skirtingas teisines ir statistines reikšmes, bet automatiniai vertėjai dažnai jas sumaišo. Kai žiniasklaida perima tokius klaidingus vertimus, visuomenė gauna iškraipytą vaizdą apie migracijos mastą ir pobūdį.

Tas pats galioja ekonomikos statistikai. Kai BVP augimo rodikliai, nedarbo statistika ar infliacijos duomenys yra klaidingai išversti ir neteisingai interpretuoti, tai gali paveikti visuomenės nuomonę apie ekonomikos valdymą ir politinius sprendimus. Tai nėra abstrakti problema – tai realus informacinio lauko iškraipymas.

Žiniasklaidos atstovai, analitikai ir visi, kurie dirba su statistiniais duomenimis viešojoje erdvėje, turėtų laikyti automatinio vertimo tikrinimą profesiniu standartu, o ne papildoma užduotimi. Tai yra atsakomybės klausimas – tiek profesinės, tiek pilietinės.

Galiausiai, verta paminėti, kad automatiniai vertimo įrankiai nuolat tobulėja. GPT tipo modeliai, integruoti į vertimo sistemas, jau dabar veikia geriau nei ankstesnės kartos įrankiai. Bet tobulėjimas nevyksta tolygiai – ir statistiniai tekstai išlieka viena sunkiausių sričių. Tol, kol automatiniai vertėjai nesugebės patikimai perteikti statistinės terminologijos, metodologinio konteksto ir priežastingumo struktūros, kritinis požiūris į verstus statistinius duomenis išliks ne pasirinkimu, o būtinybe. Statistika yra per daug svarbi, kad ją paliktume mašinų malonei be žmogiškos priežiūros.

Įrašų puslapiavimas

Ankstesnis 1 2 3 4 … 22 Kitas

Informacija

  • Kaip statistikos duomenys padeda tėvams priimti geresnius sprendimus auginant vaikus skirtingose amžiaus grupėse
  • Kaip Lietuvos gyventojų mitybos įpročiai keitėsi per pastarąjį dešimtmetį: statistikos duomenų analizė
  • Kaip statistikos duomenys atskleidžia geriausius sezoninius receptus: 10 patiekalų pagal Lietuvos maisto pirkimo tendencijas
  • Lietuvos transporto statistika 2026: kaip skaityti oficialius duomenis ir prognozuoti eismo pokyčius jūsų mieste
  • Efektyvumo metrika ir standartizacija – kaip vadybos sistemų sertifikavimas keičia įmonių veiklos rodiklius

Autorinės teisės. © 2022 Vilniaus statistikos žurnalas.

Theme: Oceanly News Dark by ScriptsTown